LLMの内側を動かして学ぶ:重み・活性・QKV・学習
言語モデルの重みを立体配置すると何が見えるのでしょう。token IDはどこにあり、学習で何が変わるのでしょう。この教材では、小型の公開3モデルの実チェックポイントと、実際のforward計算で観測した値をたどります。操作画面は記録済みデータをブラウザ内で再表示するもので、閲覧時にモデルの推論や学習は実行しません。
まず、重みは保存される数値パラメータ、活性はその入力に対して計算される一時的な値、token IDはtokenizerが定める語彙の整数インデックスです。学習は重みを変え、その結果、同じIDから計算される活性も変わります。
操作画面は英語です。モデル全体、1つのhead、1回の学習という順に試してください。
1. 3モデルで計算の違いを見る
Attention・Diffusion・MoEは、モデルの異なる側面を表す言葉です。Attentionはトークン位置間の情報を混ぜる仕組み、Diffusionは破損と復元を使う学習・生成過程、MoEは表現を選択されたFFNに振り分ける構造です。排他的な分類ではなく、今回の3モデルはすべてAttentionを使い、MoEモデルも自己回帰型です。
| Model | Computation in this lesson | Layers | Q / KV heads per layer | Head dimension | Unique parameters |
|---|---|---|---|---|---|
| Qwen3-0.6B | Dense, causal | 28 | 16 / 8 | 128 | 596,049,920 |
| MDLM-OWT | Masked diffusion, bidirectional | 12 | 12 / 12 | 64 | 169,627,218 |
| Granite 3.1 1B-A400M | Causal MoE, 8 of 32 experts per layer | 24 | 16 / 8 | 64 | 1,334,625,280 |
モデル名のサイズは概数です。Graniteは各トークンで一部のexpertを選びますが、全体では約13.3億パラメータを保存します。Qwenのチェックポイントは共有する入力埋め込みと出力行列を二重保存しており、格納係数751,632,384個に対して固有パラメータは596,049,920個です。MDLMには位置計算用の32スカラーのbufferもあります。ファイル内の数と固有パラメータ数を区別してください。
2. モデル全体を回転し、入力位置を再生する
GraniteとMoE routing weightを選び、Play token samplesを押してください。記録した入力位置を順に再表示します。Stored weight RMSへ切り替えると、トークンが変わっても保存された重みは変わりません。活性表示に戻すと入力に応じた値が見えます。ドラッグで回転でき、メニューから任意の層や単位も選べます。
3モデルに通した文章は共通です。
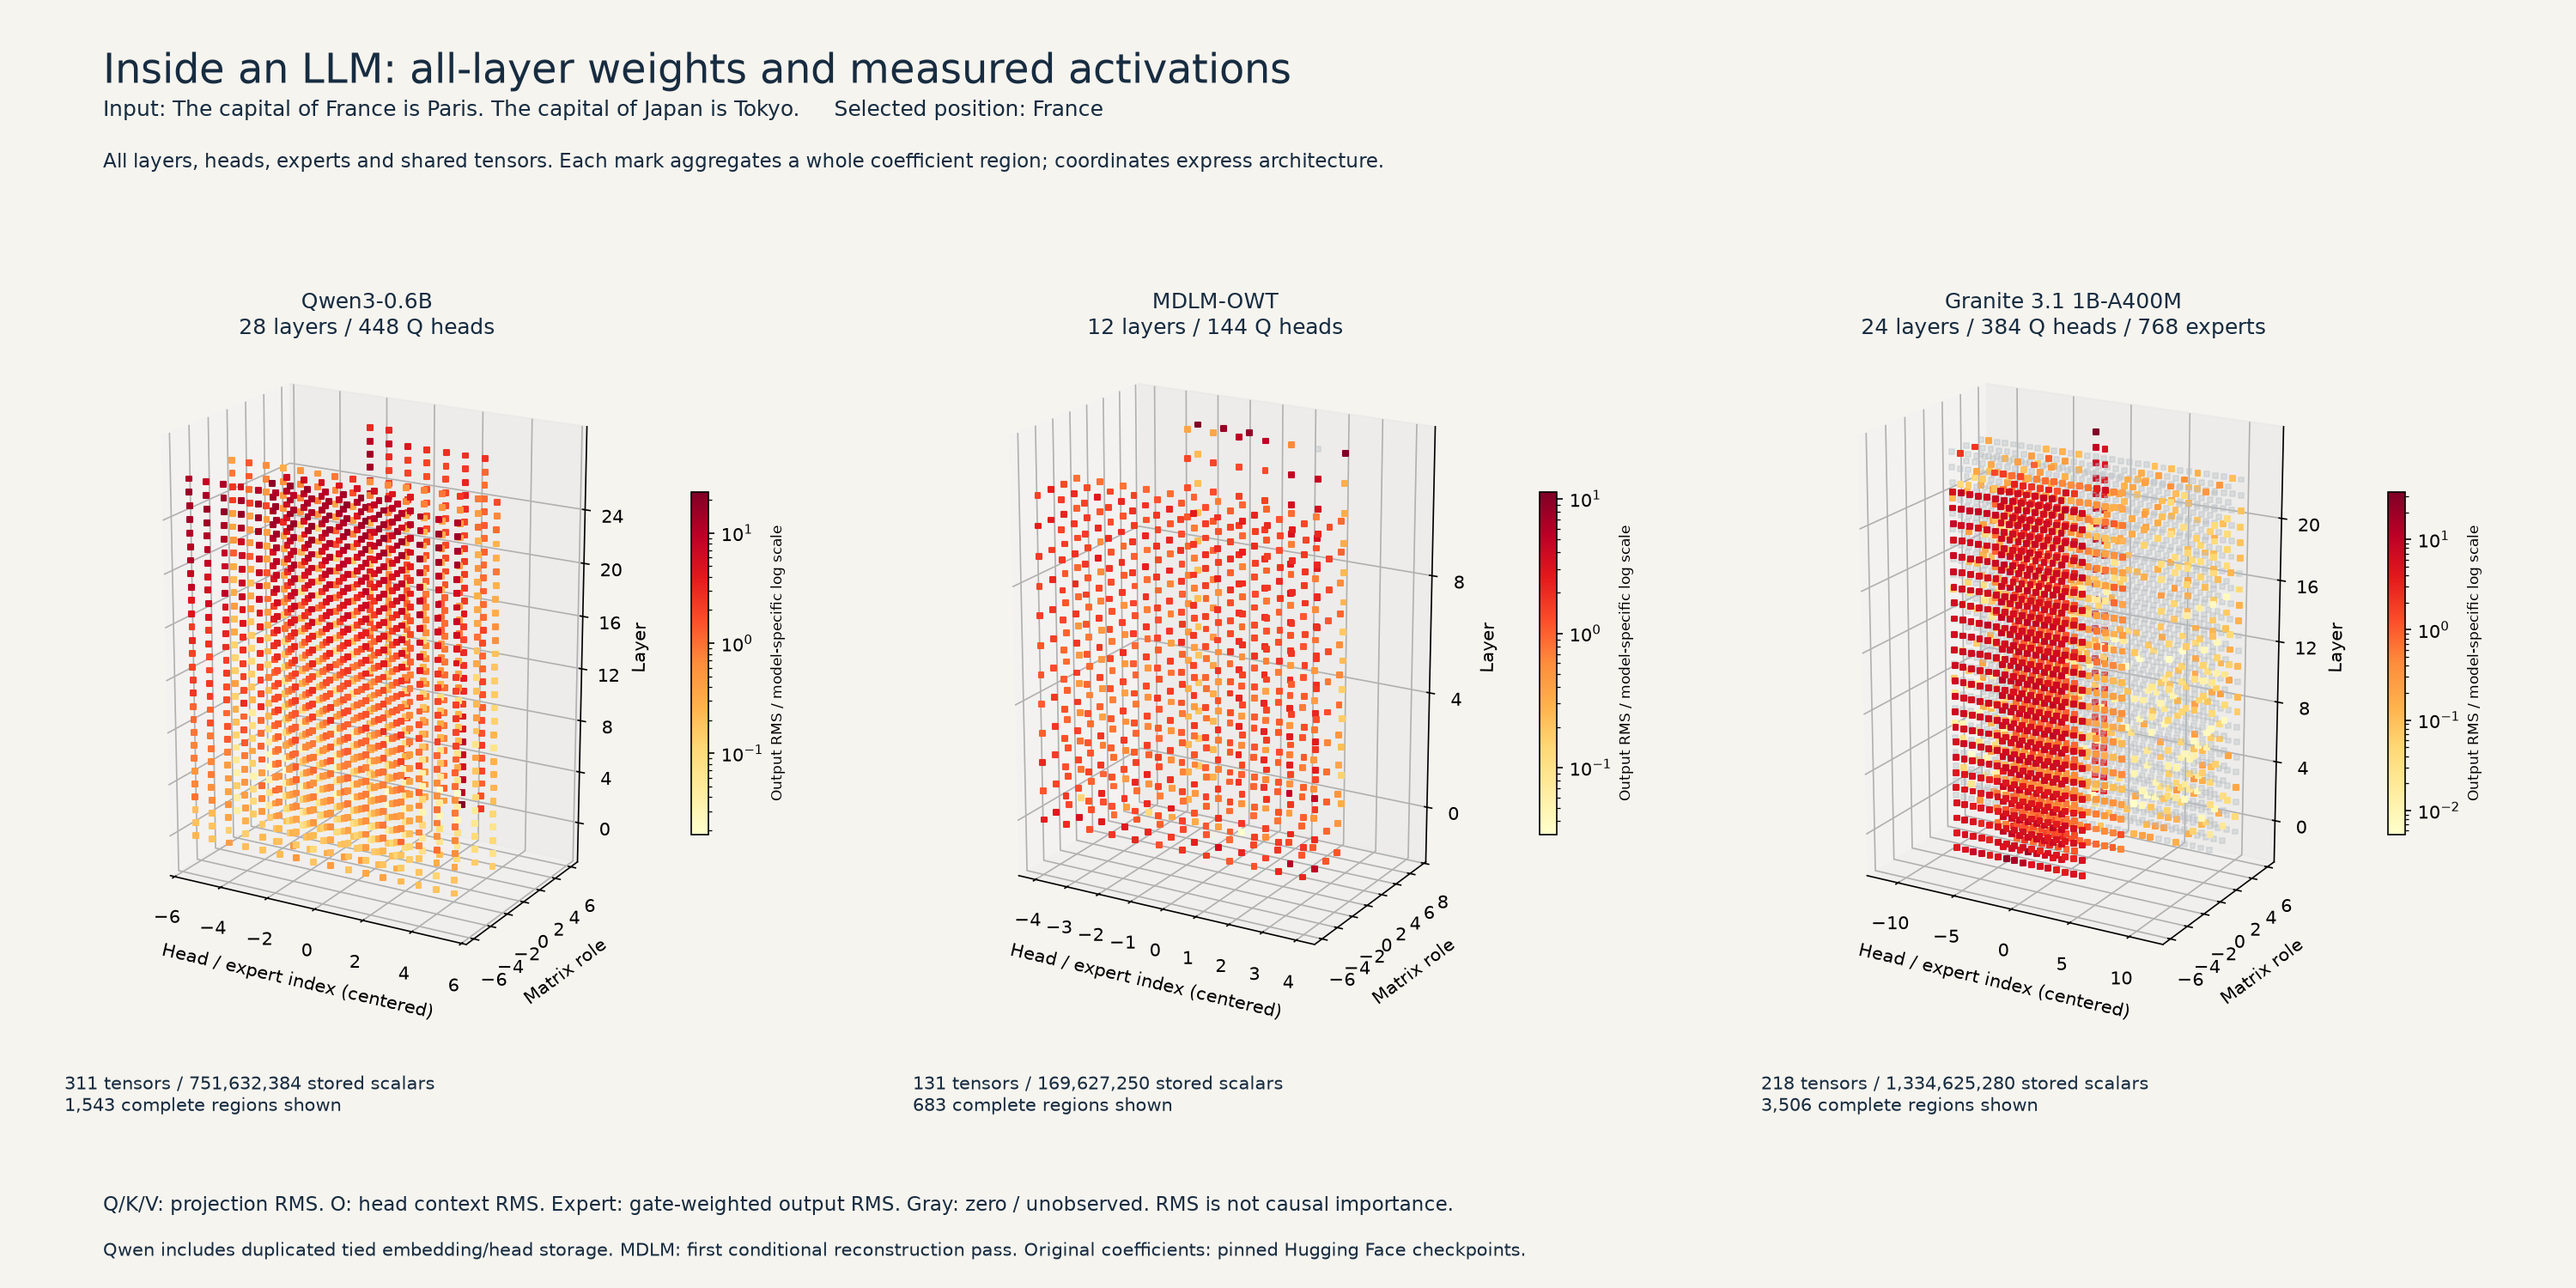
The capital of France is Paris. The capital of Japan is Tokyo.全660格納tensorを、全層・全head・全expertにわたる5,732単位へ分割しました。全係数がいずれかの単位に属し、64×64の部分切り出しではありません。各立体はhead、expertの行列、共有tensor全体を集約したものです。約22.6億の格納スカラーを1点ずつ同時描画してはいません。画面内のJSONリンクで元tensorのshape・分割・係数数・統計を、固定revisionのHugging Faceチェックポイントで元係数を確認できます。
座標は層・head/expert番号・行列の役割を表す構造座標です。学習された意味空間ではありません。色はQ/K/V投影出力のRMS、Oへ入るhead contextのRMS、expert出力にgate weightを掛けたベクトルのRMSを示します。routing表示では実gate weightです。RMSは振幅であり、正答への因果的重要度や知識量、性能ではありません。色範囲はモデル内では固定ですが、モデル間で異なります。
QwenとGraniteは文全体のcausal prefillで、最後の次トークン最尤予測は両方とも The でした。長文生成の実験ではありません。MDLMはParisとTokyoをmaskし、2回のgreedyな復元でTokyo、Parisの順に戻しました。条件付き復元の例で、論文の完全なdiffusion samplerの再現ではありません。トークン再生も、記録済みforward内の位置を見比べるもので、ハードウェア上の時間的な流れを撮影したものではありません。
3. token IDと重みはどこにある?
文字片とIDの対応はtokenizerにあります。文字片は単語、部分語、句読点、byteに由来する列などで、1文字とは限りません。埋め込み行列は、各語彙インデックスに対応する学習済みベクトルを保存します。今回のQwen tokenizerでは word はID 3409であり、埋め込み行列の3409行目を選びます。整数IDは行を選ぶアドレスで、ベクトルの数値そのものではありません。
text → tokenizer → integer IDs → E[ID] → hidden vectors through layers
     → vocabulary logits → probabilities → selected ID → tokenizer → text

Qwen checkpoint examples:
model.embed_tokens.weight               # vocabulary × hidden dimension
model.layers.0.self_attn.q_proj.weight   # output dimension × input dimension
model.layers.0.self_attn.k_proj.weight
model.layers.0.self_attn.v_proj.weight
lm_head.weight                          # vocabulary × hidden dimension
中間層はベクトルを変換し、各層にtoken ID辞書を保存する構造ではありません。出力行列の各行は語彙IDに対応し、そのIDのlogitを計算します。QwenとGraniteは入出力の重みを共有し、MDLMは別行列です。safetensorsなどのチェックポイントは、名前・shape・dtype・byte範囲を持つ数値tensorを保存します。あらゆる入力の活性パターンをそのまま恒久保存する表ではありません。
推論中の隠れ状態やAttention値はメモリ上で計算されます。自己回帰推論では過去のKeyとValueをKV cacheに保持し、再計算を省く場合があります。これは一時的な推論状態で、学習済み重みとは別物です。
4. 1つの入力表現からQuery・Key・Valueへ
Attentionの各層は、学習済みの3つの投影でQ・K・Vを作ります。Qは照合する要求、Kは照合に使う情報、Vは混ぜ合わせる内容と捉えられます。ただし、個々の成分に人間が読める意味が付いているわけではありません。以下は、チェックポイントの行列を出力次元×入力次元として書いた式です。
Q = x WQᵀ        K = x WKᵀ        V = x WVᵀ
score(i,j) = scale × dot(Q_attention[i], K_attention[j])
A[i,:] = softmax(masked scores[i,:])
context[i] = Σ_j A[i,j] × V[j]
ここでの x は、投影へ実際に入る正規化・modulation後の値であり、そのままの埋め込み行とは限りません。QwenはheadごとにQ/Kも正規化します。3モデルともQ/KにRoPEで位置を反映しますが、Vは回転させません。段階切替で投影直後とAttention入力を分けて確認できます。Graniteの設定上のscore scaleは0.015625であり、一般的な次元数の平方根の逆数に置き換えると異なる値になります。
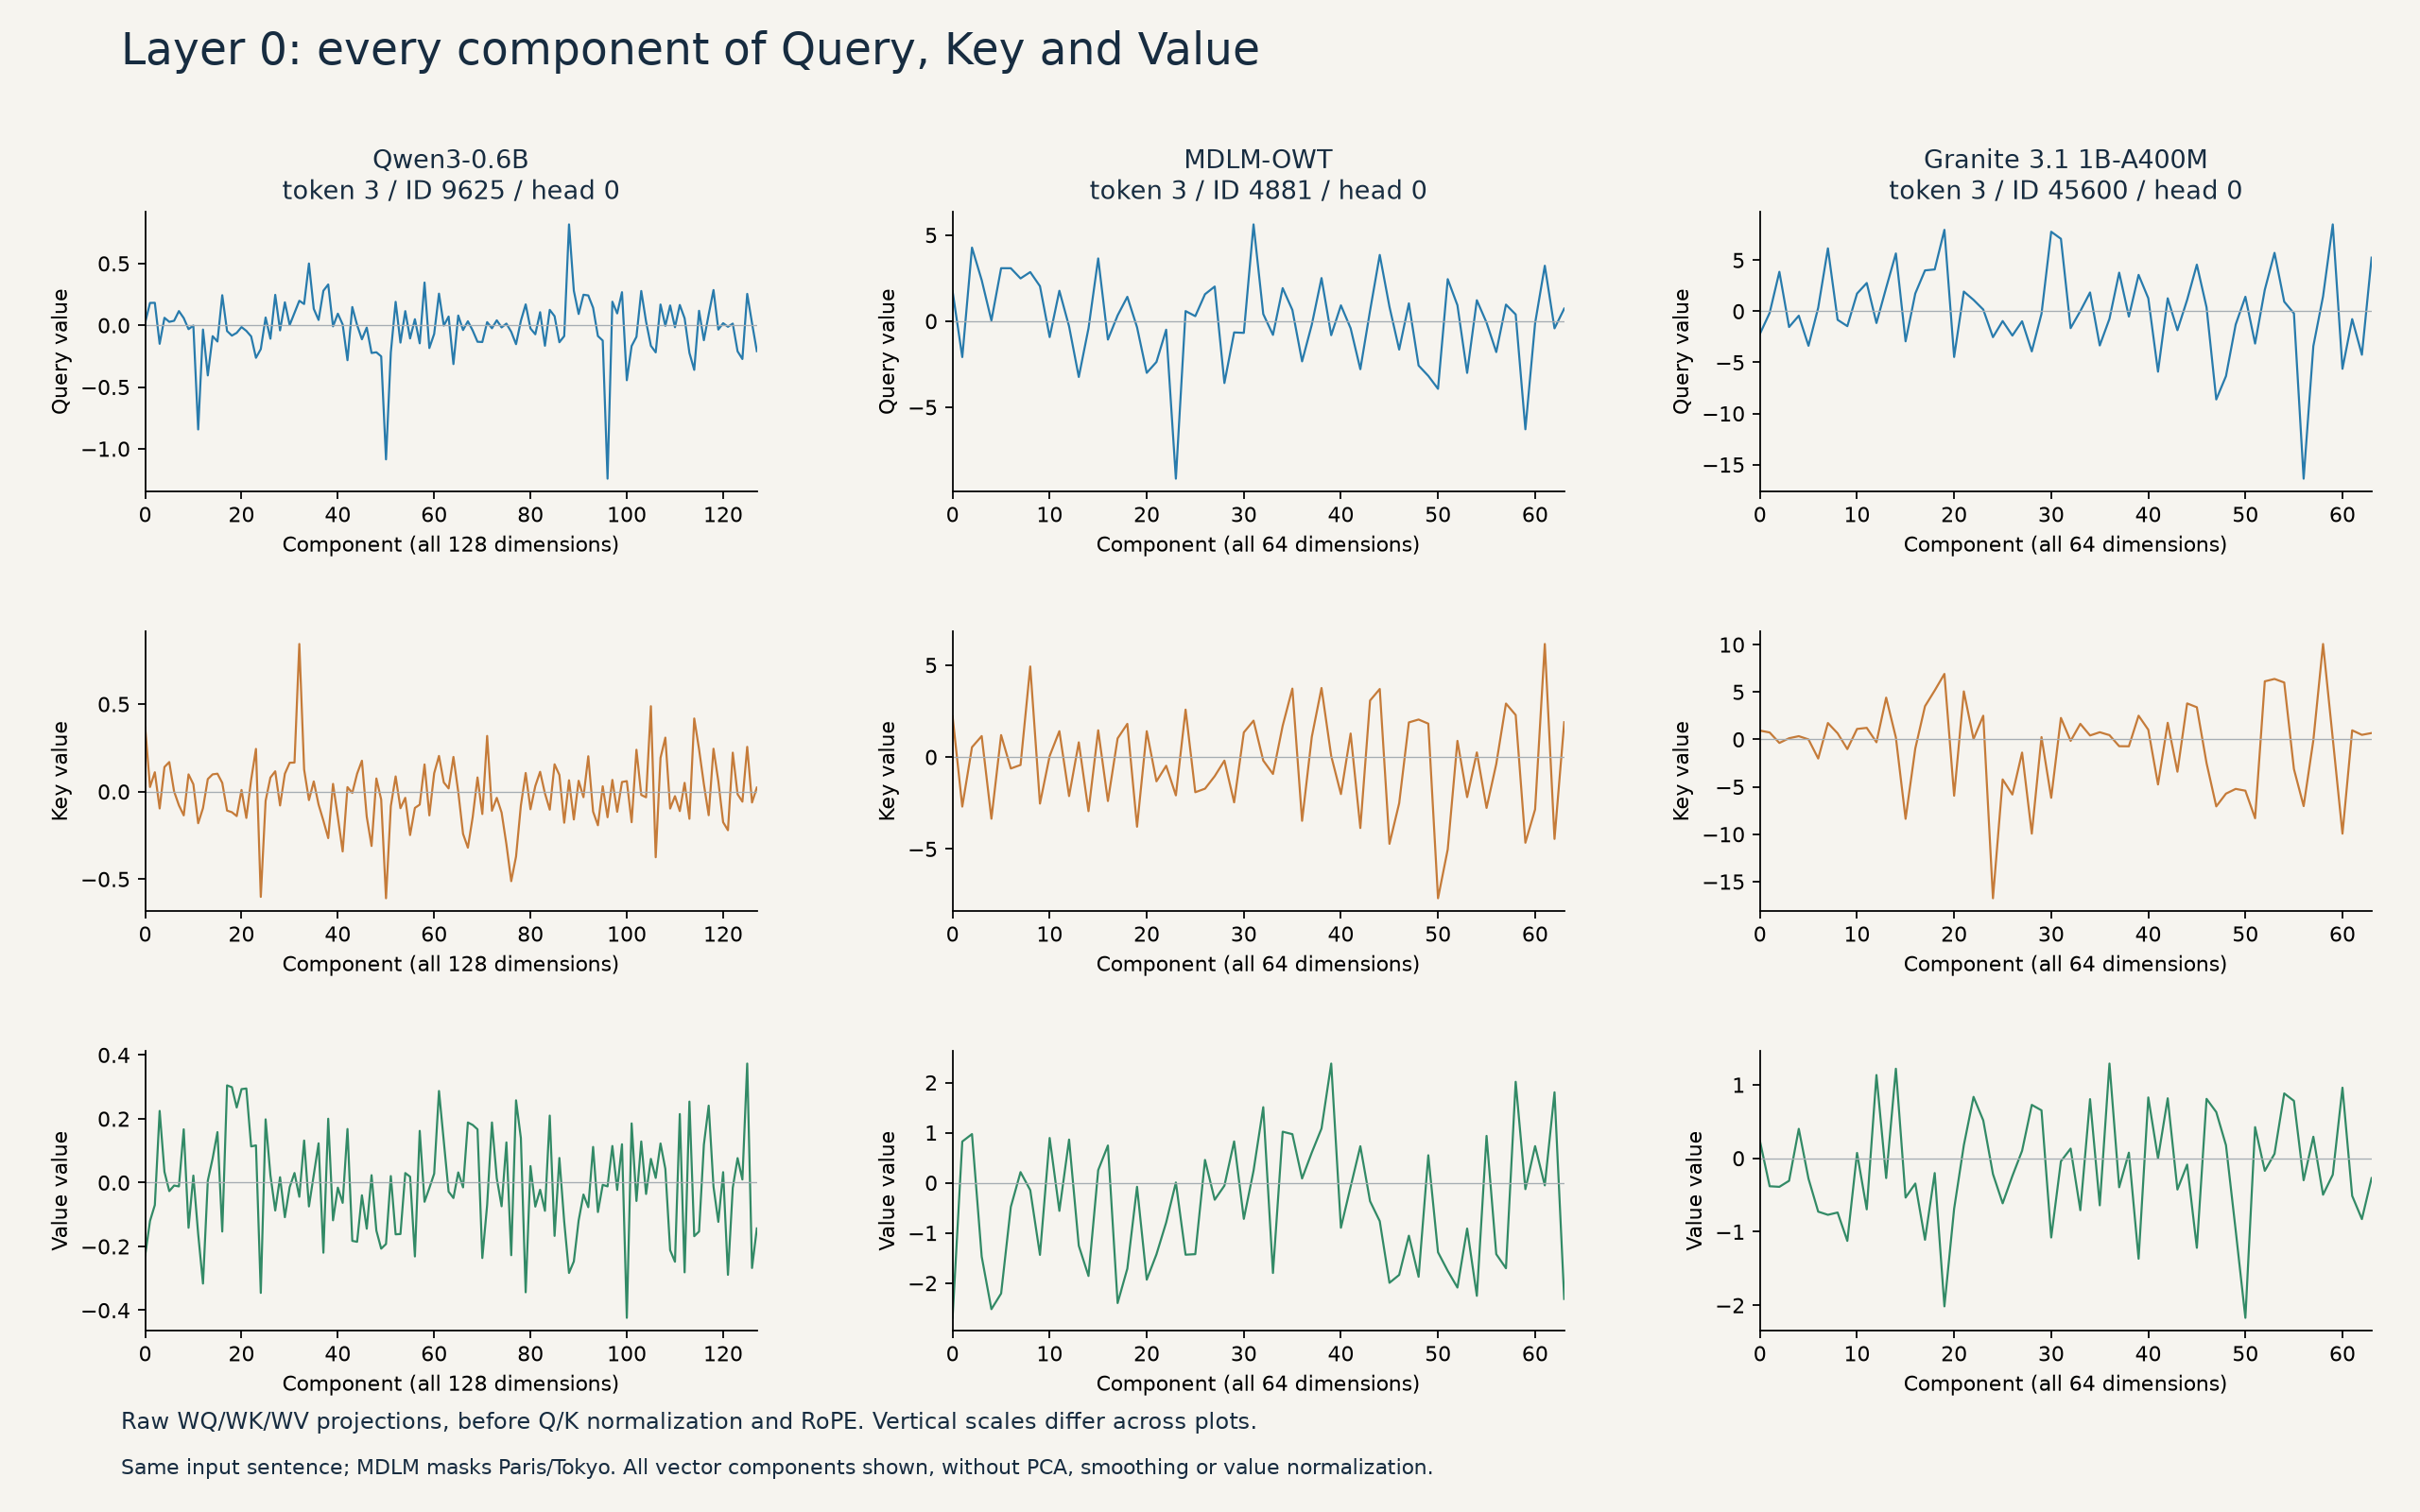
Qwenのhead 0とFranceを選び、成分sliderを動かし、埋め込み全成分も開いてみてください。Query headを0から1へ変えるとQは変わりますが、対応するK/Vは共有です。QwenとGraniteでは16本のQuery headが8本のKey/Value headを利用します。Queryより未来のKey位置を選ぶと、causal attentionでは確率が0になります。MDLMは双方向を参照できます。
この画面は第0層の全トークン・全headについて、選択したベクトルの128または64成分をすべて表示します。PCAや次元の間引きではありません。縦軸は図ごとに異なります。上の線を投影直後へ切り替えても、下のAttentionはQ/Kの変換とmaskを反映した実モデルの値です。
5. 学習はどうやってパターンを覚える?
通常、モデルは「この文字列がこのニューロンを活性化した」という記録を別表へ保存しません。損失を計算し、各演算を通して微分し、係数を調整します。その結果、将来の入力に対する隠れ状態と予測の計算が変わります。知識や振る舞いは多くのパラメータに分散しており、活性だけで知識の保存場所が証明されるわけではありません。
Denseな自己回帰モデルは通常、causal maskの下で次のtokenを学習します。Masked diffusionはサンプルしたノイズ・mask量で入力を破損し、目的関数に応じた重みづけで復元を学びます。MoE言語モデルでは、言語モデル損失が選択expertとrouting weightへ伝わり、routingの補助損失を使う場合もあります。非選択expertには、そのtokenの通常の選択expert経路からの寄与は伝わりません。多数のtokenを通して、別のexpertも選択・学習されます。
次のアニメーションは、dropoutを切り、学習率0.01で1例にSGDを1回行った実験です。Qwen/Graniteは The secret word is の次の apple を、MDLMはmaskしたapple位置を学習します。基底モデルを固定し、入力埋め込み1行の差分と最終層FFNの出力行列だけを更新し、Graniteは最終routerも更新しました。埋め込み差分へ届く勾配は固定層も通過します。元の事前学習を再現したものではありません。
PlayまたはNextで、文字→ID→埋め込み選択→全層forward→語彙の点数→損失と逆伝播→更新→同じIDで再forwardを追えます。予測計算を1つの場面へまとめた7段階です。係数表のBeforeとCurrentを比べてください。移動する印と行列の形は模式表現ですが、始点・終点の係数、損失、確率は実測です。途中の補間は観測したoptimizerの軌跡ではありません。
| Model | Target ID | Cross-entropy before | Cross-entropy after |
|---|---|---|---|
| Qwen3-0.6B | 23268 | 12.416276 | 0.001918 |
| MDLM-OWT | 17180 | 16.440016 | 14.581282 |
| Granite 3.1 1B-A400M | 38955 | 8.933086 | 0.000000119 |
この数値は1つの学習例への適合を示すもので、一般能力向上の証拠ではありません。MDLMの正解確率は約7.25e-8から4.65e-7へ増えましたが、最尤予測にはなっていません。Qwen/Graniteの大きな変化も、一般化や保持を証明しません。入出力共有モデルでは同じ埋め込み行差分を両経路に適用しました。元checkpointは変更せず、実験更新を別保存しました。通常の全parameter事前学習では、多数のbatchを通して、はるかに広い範囲を更新します。
6. 実測値と模式表現、検証方法
上表の固定revisionから3モデルの全checkpointを取得し、公開LFS SHA-256と照合し、全格納係数を走査しました。3D表示は全領域の統計、QKV表示はBF16のbit列も含めた全表示成分の可逆保存です。読者がモデルをダウンロードする必要はありません。
Qwen/Graniteの推論はTransformers 5.4.0・PyTorch 2.6.0・MPS・eager attention、元のBF16重みです。MDLMは著者の重みとコードを使い、CUDA専用Attention・RoPE・融合演算を同じ数式のTorch eager演算へ置き換え、F32/MPSで実行しました。CUDA kernelとのbit一致は未検証です。Graniteの部分学習はMPSのBF16 backwardが未対応だったため、重みを正確にFP32へ変換しました。目的関数には設定済みrouter補助損失も含め、表はcross-entropy部分だけを示します。
観測コードの有無による最終logitの最大差は0でした。第0層の実投影入力と元行列からQ/K/Vを再計算した最大差も0、全層のQK scoreとAttention×Vのcontext再計算も最大差0でした。今回の実装・入力における数値の整合性を確認するもので、個々のニューロンの意味を証明する検査ではありません。
配置は走査したモデルの構造を表します。Dense・Diffusion・MoEが本質的に3種類の幾何形状を持つと証明するものではありません。元の議論にあった連続Diffusion版Sigmaは、正規公開checkpointを特定できず未解析です。MDLMをSigmaの実測値として扱ってはいません。
データと一次資料
- manifestとSHA-256、全係数網羅検証、QKV数値検証、部分学習検証。
- 実学習ログ:Qwen、MDLM、Granite。推論環境。
- 元モデルカード:Qwen3-0.6B、MDLM-OWT、IBM Granite。3モデルともApache 2.0で公開されており、条件・帰属は各repositoryを参照してください。
- MDLM論文・実装、Attention Is All You Need、safetensors形式。
実測・教材作成日は2026年11月5日です。対話表示にはDecompressionStream対応browserを使用してください。表紙とQKV全成分の静的図でも確認できます。